La mayoría de los negocios pagamos una o varias suscripciones de IA: ChatGPT, Gemini, Copilot. Y casi todos trabajábamos con la misma idea: pago la cuota y puedo usar todo lo que quiera. Pero actualmente, nos aparecen mensajes que nos dicen lo contrario: “Ha llegado a su límite” o “Pasa a un plan superior” Esto se debe a que en todas las suscripciones se aplican unos límites de uso. Por ejemplo, Claude tiene un tiempo de límite por sesión (de 5 horas) y otro semanal. Si te pasas del límite te capan. Lo mismo ocurre con ChatGPT y la mayoría de modelos de IA.
Con el tiempo, vamos a pagar la IA igual que la luz o el gas: por consumo. Por eso, conviene que entendamos bien cómo funciona el contador de la IA. Tanto para los que tienen contratado suscripciones como los que ya pagan por el uso vía API (la vía de acceso directo al modelo que se factura por consumo). Cuanto antes entendamos el contador, antes podremos ahorrar.
A continuación, os explicamos los conceptos claves y los tips para ahorrar.
¿Qué son los tokens?
Aunque queramos ver a la IA como algo mágico o, todo lo contrario, como algo catastrófico, la IA es software. Como sabemos, las máquinas funcionan con números, todo lo que procesan es puro cómputo. En el caso de la IA no es una excepción, ya que lo que hace la IA es dividir el texto, imagen o audio que introducimos en un chat, en partes o fragmentos.
Cada fragmento se le asigna un número de identificación o ID, que se realiza a partir de un algoritmo matemático o herramienta llamada tokenizador. Estos fragmentos se les llama tokens y es la unidad de medida por lo que las empresas de IA cobran al usuario. Cada token se asocia con un único identificador numérico, y a cada nueva palabra se le asigna un nuevo identificador.
Por tanto, los modelos grandes de lenguaje (LLM) que utilizamos habitualmente como ChatGPT, DeepSeek, Claude o Gemini no leen palabras, letras ni frases. Leen y escriben tokens. Los tokens son como las “piezas” en las que la IA divide el texto antes de procesarlo. Aunque nos vamos a centrar en texto, las imágenes y el audio también se convierten en tokens. Una captura de pantalla o la foto de una factura pueden suponer unos 1.000-1.500 tokens, por ejemplo.
¿Cómo calculamos los tokens que consumimos?
Si la luz se cobra por kWh y el agua por m3, la IA se cobra por tokens, en concreto, se cobra un precio por cada millón de tokens.
Pero si nos dicen que la IA se cobra por tokens, ¿cuántos tokens equivalen a un documento de 400 palabras en español? Pues deciros que no hay una regla escrita o universal que determine cuántos tokens equivalen a una palabra, sino que cada empresa de IA aplica su propio criterio.
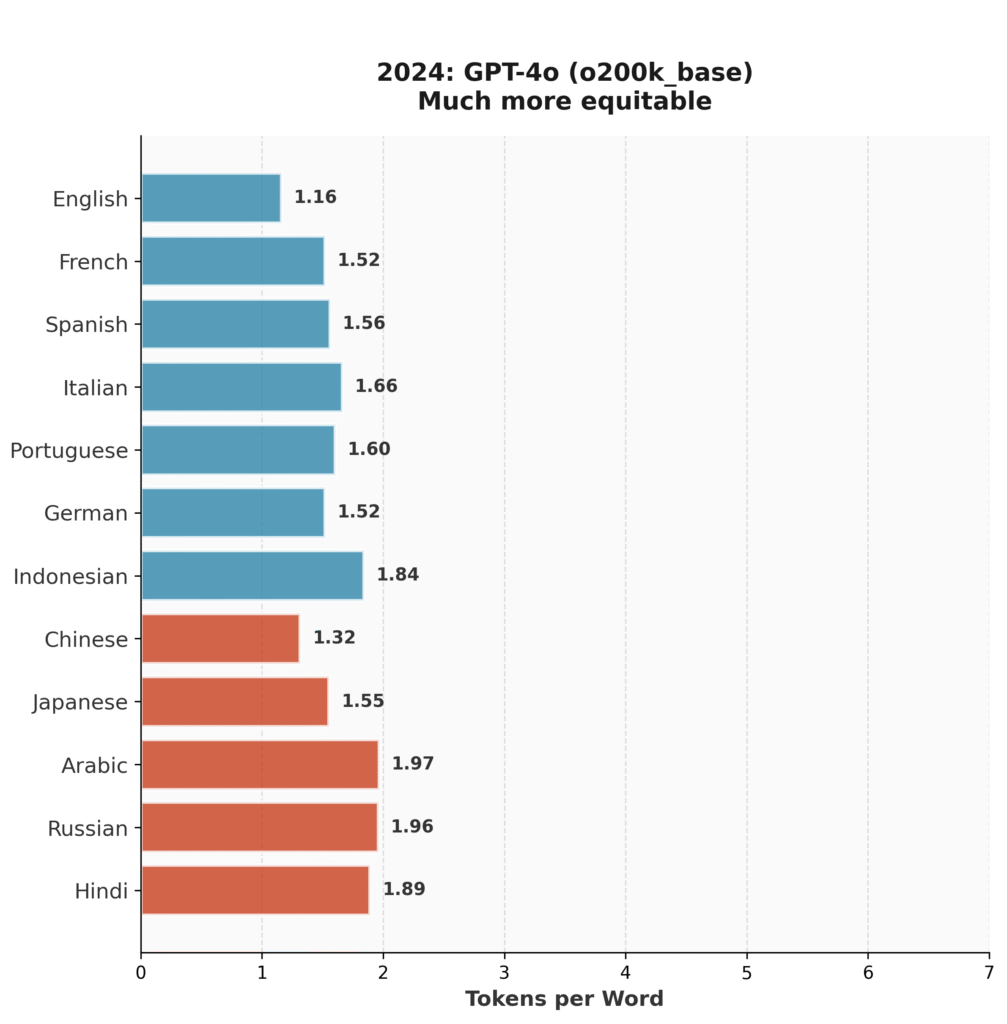
Son muy similares porque todos han adoptado el patrón de la empresa pionera OpenAI. En la página de OpenAI puedes calcular el número de tokens y nos explican que en inglés un token equivale a ¾ partes de una palabra. Es decir, un token = 0,75 por palabra o cada palabra equivale a 1,33 tokens. Si un documento en inglés tiene 400 palabras supone 533 tokens.
En español, el token es más caro por la morfología de nuestro idioma. Lo podemos comprobar cuando queremos leer un libro en español y el mismo en inglés, en español siempre tiene más páginas. A mayor cantidad de caracteres mayor número de fragmentos o tokens. Si en inglés cada palabra equivale a 1,33 tokens, en español sube a 1,6 tokens como podéis ver en la imagen de abajo.
Así que 400 palabras en español equivalen a 640 tokens, un 21% más que en inglés en este caso.
¿Cuál es el precio que pagamos por cada millón de tokens?
Ya sabemos que la unidad de medida para calcular nuestro consumo en IA es el token y que en español una palabra equivale a 1,6 tokens aprox. Ahora necesitamos saber lo que nos cuesta cada millón de tokens. Porque su precio es diferente por 4 motivos:
1. Tokens de entrada: todo lo que enviamos al modelo. Es lo más barato. Por ejemplo, en el modelo Gemini 3.8 Flash cuesta 0,75 dólares por millón de tokens.
2. Tokens de salida: la respuesta que nos genera el modelo. La salida cuesta al menos 5 veces más que la entrada, porque generar texto exige mucho más cálculo que leerlo. En el modelo Gemini 3.8 Flash cuesta 3,75 dólares por millón de tokens.
3. Tipo de modelo: no es el mismo precio el token en un modelo avanzado que uno básico, tanto en el precio de salida como de entrada. Si vemos esta calculadora podemos saber los precios de salida o output de los principales modelos actuales. Por ejemplo, en el modelo GPT 6 Luna el coste es de salida es de 0,5 dólares por cada millón de tokens. En cambio, en el GPT 6 Astra el precio se dispara a 50 dólares por cada millón de tokens. El modelo sencillo de ChatGPT cuesta 100 veces menos que el más avanzado. Así ocurre en la totalidad de proveedores de IA.
4. Modelos de razonamiento o Reasoning LLM: los modelos de razonamiento, específicos para razonar en tareas complejas, aparecieron hace dos años. Pero en la actualidad, los principales modelos más avanzados o frontera de cada proveedor (OpenAI, Anthropic, DeepSeek…) tienen esta cualidad. Lo que ocurre es que cuando piensan consumen tokens de salida, en gran número y que son los más caros de los tokens. Por ejemplo, hacemos una consulta que consume 300 tokens de entrada y 90 de salida. La suma de tokens de nuestra consulta no sería de 390, sino habría que añadirle los 420 de razonamiento, total 810 tokens. De los que 510 serían tokens de salida, los más caros.
Un ejemplo del coste final o lo que pagamos:
La fórmula para calcular el coste del consumo de IA es el siguiente:

Supongamos que hacemos 200 consultas al mes a documentos que subimos a un modelo de IA. Si por cada consulta, los tokens de entrada son 30.300 tokens a 3 dólares y de salida 800 tokens a 15 dólares, la factura sería la siguiente:
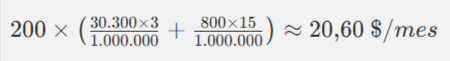
Recordemos que el precio es por millón de tokens.
¿Cómo podemos ahorrar? 5 claves
Ya sea que tengas una suscripción o tarifa plana mensual o pagues vía API, lo que necesitas es consumir lo mínimo posible en cada consulta. Si estás suscrito porque evitarás llegar a los límites de tu plan y si pagas por consumo porque reducirás tu factura considerablemente.
Si quieres ahorrar te explicamos 5 tips o reglas clave para que consigas ahorrar en IA:
- Un solo chat y que sea corto.
Los modelos no tienen memoria. El modelo no recuerda nada, cada vez que envías un mensaje dentro de una misma conversación, la plataforma reenvía al modelo la conversación completa desde el principio: el documento que subiste, todas tus preguntas anteriores y todas sus respuestas.
Te comento un caso real que nos pasó. Cuando apareció la AI act o Ley de la IA, el Reglamento de Inteligencia Artificial estuvimos una semana con consultas diversas, en un mismo chat con el documento del Reglamento adjunto. Este documento de 144 páginas puede tener unas 100.000 palabras. Cada nueva consulta en ese chat volvía a “arrastrar” el documento completo, más todas las preguntas y respuestas anteriores. El consumo fue brutal. Si, en cambio, hubiéramos hecho cada bloque de consultas en un chat nuevo, sin arrastrar toda la conversación, el coste habría sido ínfimo.
Solución: abre un nuevo chat cada vez que realices una petición o prompt. Agrupa tus preguntas, no hagas tus consultas de una en una sobre un mismo tema o documento adjunto.
- Elige el modelo por tarea a realizar y no por costumbre.
Dentro de un mismo proveedor, la diferencia de precio entre el modelo de IA más básico al más potente es enorme como hemos visto antes con el modelo GPT 6, concretamente 100 veces más caro. La mayoría de las tareas de un negocio no necesitan el modelo top. Solo si necesitamos analizar o crear algo complejo, el resto nos vale con modelos básicos. Y cada vez que la IA avance, y lo hace cada mes, en breve el modelo avanzado de hoy será el básico pasado mañana.
Solución: reserva la gama alta para lo difícil y usa la económica para lo demás. Empezad por el modelo económico y cambiar al modelo premium solo si el resultado no da la talla.
- Limita la subida
Elimina la paja: Si vas a pasarle a la IA un informe en PDF de 200 páginas donde solo te interesan los anexos finales, recorta las páginas sobrantes antes de adjuntarlo. Todo lo que subas de más son tokens consumidos que tendrás que pagar.
Solución: solo sube el contenido del documento que le vas a consultar. No subas documentos completos, solo las partes relevantes.
- Limita la salida
La salida cuesta, como mínimo, cinco veces más que la entrada. Pide tres propuestas, no veinte, si solo vas a leer tres. Pide máximo 200 palabras o máximo ocho puntos y así evitarás respuestas largas e innecesarias.
Solución: pon límites a la respuesta del modelo, pídele que sea preciso.
- Define la tarea antes de consultar
Lo más común es que le hagamos una consulta al modelo y después otra y otra y empezamos una larga conversación que solo nos consume tokens. Lo mejor es pedirle lo que necesitas, una vez que has pensado bien lo que quieres.
Solución: define bien la tarea antes de usar IA. No pidas “ayúdame con esto” si puedes pedir un resultado concreto.